java反序列化入门篇-01-概念初相识 也是学到java了,java确实方便,各种封装好的函数随便用,整一个就是调用调用再调用,但可以利用的地方也很多,果然便利是安全最大的敌人。
什么是反序列化 一步一步学过来的师傅们肯定对反序列化的定义和原理都不太陌生了,但想必以前都是接触的PHP反序列化。那java反序列化存在的意义又是什么呢?我们知道,当两个进程进行远程通信时,可以相互发送各种类型的数据,包括文本、图片、音频、视频等, 而这些数据都会以二进制序列的形式在网络上传送。那么当两个Java进程进行通信时,能否实现进程间的对象传送呢?答案是可以的。如何做到呢?这就需要Java序列化与反序列化了。换句话说,一方面,发送方需要把这个Java对象转换为字节序列,然后在网络上传送;另一方面,接收方需要从字节序列中恢复出Java对象。
在具体学习之前,我们先来一个栗子体会一下序列化和反序列化ba
Animal 是父类,它没有实现 Serilizable 接口
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class Animal {private String color;public Animal () {"调用 Animal 无参构造" );public Animal (String color) {this .color = color;"调用 Animal 有 color 参数的构造" );@Override public String toString () {return "Animal{" +"color='" + color + '\'' +'}' ;
BlackCat 是 Animal 的子类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class BlackCat extends Animal implements Serializable {private static final long serialVersionUID = 1L ;private String name;public BlackCat () {super ();"调用黑猫的无参构造" );public BlackCat (String color, String name) {super (color);this .name = name;"调用黑猫有 color 参数的构造" );@Override public String toString () {return "BlackCat{" +"name='" + name + '\'' +super .toString() +'\'' +'}' ;
SuperMain 测试类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
public class SuperMain {private static final String FILE_PATH = "./super.bin" ;public static void main (String[] args) throws Exception {private static void serializeAnimal () throws Exception {BlackCat black = new BlackCat ("black" , "我是黑猫" );"序列化前:" +black.toString());"=================开始序列化================" );ObjectOutputStream oos = new ObjectOutputStream (new FileOutputStream (FILE_PATH));private static void deserializeAnimal () throws Exception {"=================开始反序列化================" );ObjectInputStream ois = new ObjectInputStream (new FileInputStream (FILE_PATH));BlackCat black = (BlackCat) ois.readObject();
输出
1
2
3
4
5
6
7
调用 Animal 有 color 参数的构造name ='我是黑猫' Animal{color ='black' }'} =================开始序列化================ =================开始反序列化================ 调用 Animal 无参构造 BlackCat{name=' 我是黑猫'Animal{color=' null '}' }
从上面的执行结果来看,如果要序列化的对象的父类 Animal 没有实现序列化接口,那么在反序列化时是会调用对应的无参构造方法的,这样做的目的是重新初始化父类的属性,例如 Animal 因为没有实现序列化接口,因此对应的 color 属性就不会被序列化,因此反序列得到的 color 值就为 null。根本原因是序列化只会存储本类中声明的成员变量 ,且只有当前类自身实现了Serlizable,本类的成员变量才会被序列化保存到文件中,而上面的案例中,color这个属性是通过super来赋值的,并不算BlackCat类。
序列化和反序列化原理 serialVersionUID java的序列化和反序列化需要一个关键的东西:序列化ID(serialVersionUID),它决定是否能够成功反序列化。这是因为java的序列化机制是通过判断运行时类的serialVersionUID来验证版本一致性的,在进行反序列化时,JVM 会把传进来的字节流中的serialVersionUID与本地实体类中的serialVersionUID进行比较,如果相同则认为是一致的,便可以进行反序列化,否则就会报序列化版本不一致的异常。而验证版本一致性是为了检查这个类是否存在过修改,若是修改过我们的反序列化数据就可能不适用于现在这个类。
序列化 对于序列化来说,最关键的是writeObject,序列化其实就是调用了这个函数而已,但里面到底发生了什么才是我们真正需要学习的
简单来说,序列化就是完成了以下步骤:
将对象实例相关的类元数据输出。
递归地输出类的超类描述直到不再有超类。
类元数据完了以后,开始从最顶层的超类开始输出对象实例的实际数据值。
从上至下递归输出实例的数据
1
2
所谓类元数据就是序列化流里保存的类信息
下面就来看看代码来理解一下
ObjectOutputStream 构造函数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
public ObjectOutputStream (OutputStream out) throws IOException {new BlockDataOutputStream (out);new HandleTable (10 , (float ) 3.00 );new ReplaceTable (10 , (float ) 3.00 );false ;true );if (extendedDebugInfo) {new DebugTraceInfoStack ();else {null ;
bout:用于写入一些类元数据还有对象中基本数据类型的值,在下面会分析。
enableOverride :false 表示不支持重写序列化过程,如果为 true ,那么需要重写 writeObjectOverride 方法。这个一般不用管它。
writeStreamHeader() 写入头信息,具体看下面分析。
ObjectOutputStream#writeStreamHeader()
1
2
3
4
protected void writeStreamHeader () throws IOException
ok,上面就是将数据转为流存入,了解到这就够了,下面来看看writeObjectba
1
2
3
4
5
6
7
8
9
10
11
12
13
14
public final void writeObject (Object obj) throws IOException {if (enableOverride) {return ;try {false );catch (IOException ex) {if (depth == 0 ) {throw ex;
ObjectOutStream#writeObject0()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
private void writeObject0 (Object obj, boolean unshared) throws IOExceptiontry {Object orig = obj;true );if (obj instanceof Class) {else if (obj instanceof ObjectStreamClass) {else if (obj instanceof String) {else if (cl.isArray()) {else if (obj instanceof Enum) {else if (obj instanceof Serializable) {else {if (extendedDebugInfo) {throw new NotSerializableException ("\n" + debugInfoStack.toString());else {throw new NotSerializableException (cl.getName());
lookup 函数用于查找当前类的 ObjectStreamClass ,它是用于描述一个类的结构信息的,通过它就可以获取对象及其对象属性的相关信息,并且它内部持有该对象的父类的 ObjectStreamClass 实例。其内部大量使用了反射,感兴趣的师傅可以去看看这个类的源码。下面看看它的构造函数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
private ObjectStreamClass (final Class<?> cl) {this .cl = cl;null ) ? lookup(superCl, false ) : null ;this ;
根据 obj 的类型去执行序列化操作,如果不符合序列化要求,那么会抛出 NotSerializableException 异常
ObjectOutputStream#writeOrdinaryObject
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
private void writeOrdinaryObject (Object obj, ObjectStreamClass desc, boolean unshared) throws IOExceptiontry {false );null : obj);if (desc.isExternalizable() && !desc.isProxy()) {else {finally {if (extendedDebugInfo) {
写入类的元 数据,TC_OBJECT. 声明这是一个新的对象,如果写入的是一个 String 类型的数据,那么就需要 TC_STRING 这个标识。 编程
writeClassDesc 方法主要作用就是自上而下(从父类写到子类,注意只会遍历那些实现了序列化接口的类)写入描述信息。该方法内部会不断的递归调用,我们只需要关系这个方法是写入描述信息就好了,想要深入研究的师傅阔以看看源码。
从这里可以知道,序列化过程需要额外的写入很多数据,例如描述信息,类数据等,因此序列化后占用的空间肯定会更大。
desc.isExternalizable() 判断需要序列化的对象是否实现了 Externalizable 接口,在序列化过程就是在这个地方进行判断的。如果有,那么序列化的过程就会由程序员自己控制了哦,writeExternalData 方法会回调,在这里就可以愉快地编写需要序列化的数据拉。
writeSerialData 在没有实现 Externalizable 接口时,就执行这个方法
ObjectOutputstream#writeSerialData
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
private void writeSerialData (Object obj, ObjectStreamClass desc) throws IOExceptionfor (int i = 0 ; i < slots.length; i++) {ObjectStreamClass slotDesc = slots[i].desc;if (slotDesc.hasWriteObjectMethod()) {PutFieldImpl oldPut = curPut;null ;SerialCallbackContext oldContext = curContext;if (extendedDebugInfo) {"custom writeObject data (class \"" +"\")" );try {new SerialCallbackContext (obj, slotDesc);true );this );false );finally {if (extendedDebugInfo) {else {
desc.getClassDataLayout 会返回 ObjectStreamClass.ClassDataSlot[] ,我们来看看 ClassDataSlot 类,可以看到它是封装了 ObjectStreamClass 而已,所以我们就简单的认为1这一步就是用于返回序列化对象及其父类的 ClassDataSlot[] 数组,我们可以从 ClassDataSlot 中获取对应 ObjectStreamClass 描述信息。
1
2
3
4
5
6
7
8
9
10
static class ClassDataSlot {final ObjectStreamClass desc;final boolean hasData;boolean hasData) {this .desc = desc;this .hasData = hasData;
到2这开始遍历返回的数组,slotDesc 这个我们就简单将其看成对一个对象的描述吧。hasWriteObjectMethod 表示的是什么呢?这个其实就是你要序列化这个对象是否有 writeObject 这个 private 方法,注意哦,这个方法并不是任何接口的方法,而是我们手动写的。那么这个方法的作用是什么呢?这个方法我们在上面也演示过具体的使用,它就是用于自定义序列化过程的,可以返回到上面看看如果使用这个 writeObject 实现自定义序列化过程的。注意:其实这个过程不像实现 Externalizable 接口那样,自己完全去自定义序列化 数据。
defaultWriteFields 这个方法就是 JVM 自动帮我们序列化了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
private void defaultWriteFields (Object obj, ObjectStreamClass desc) throws IOExceptionint primDataSize = desc.getPrimDataSize();if (primVals == null || primVals.length < primDataSize) {new byte [primDataSize];0 , primDataSize, false );false );new Object [desc.getNumObjFields()];int numPrimFields = fields.length - objVals.length;for (int i = 0 ; i < objVals.length; i++) {if (extendedDebugInfo) {"field (class \"" + desc.getName() + "\", name: \"" +"\", type: \"" +"\")" );try {finally {if (extendedDebugInfo) {
这个方法主要分为以下两步
写入基本数据类型的数据
写入引用数据类型的数据,这里最终又调用到了 writeObject0() 方法,忘了可以返回到上面去看看具体的实现。
反序列化 反序列化的关键当然就是readObject 拉
反序列化代码原理和前面是对应的,我们就不再详细read,讲讲提一提关键的部分就好,觉得前面还没捋清楚的师傅也推荐可以看看,可以前后对照更好理解。从流中读取类的描述信息 ObjectStreamClass 实例,通过这个对象就可以创建出序列化的对象。
1
2
3
4
5
6
7
8
9
10
11
ObjectStreamClass desc = readClassDesc(false );try {null ;catch (Exception ex) {throw (IOException) new InvalidClassException ("unable to create instance" ).initCause(ex);
读取该对象及其对象的父类的 ObjectStreamClass信息
1 ObjectStreamClass.ClassDataSlot[] slots = desc.getClassDataLayout();
然后遍历得到每一个 ObjectStreamClass 对象,将对应的属性值赋值给需要反序列化的对象。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
private void defaultReadFields (Object obj, ObjectStreamClass desc) throws IOExceptionif (cl != null && obj != null && !cl.isInstance(obj)) {throw new ClassCastException ();int primDataSize = desc.getPrimDataSize();if (primVals == null || primVals.length < primDataSize) {new byte [primDataSize];0 , primDataSize, false );if (obj != null ) {int objHandle = passHandle;false );new Object [desc.getNumObjFields()];int numPrimFields = fields.length - objVals.length;for (int i = 0 ; i < objVals.length; i++) {ObjectStreamField f = fields[numPrimFields + i];if (f.getField() != null ) {if (obj != null ) {
反射 反射:程序运行期间,动态获取一个类的全部信息、并且动态调用它的构造方法、普通方法、成员变量的能力。正常代码是编译期就确定要调用哪个类、哪个方法;反射是运行时才决定操作哪个类、执行哪个函数。用我的大白话来说反射就是操作Class,所谓反射就是让我们能够重新对这个类进行操作。
反射初使用 先简单来read一下反射的使用过程:
获取 Class 对象 :首先获取目标类的 Class 对象。获取成员信息 :通过 Class 对象,可以获取类的字段、方法、构造函数等信息。操作成员 :通过反射 API 可以读取和修改字段的值、调用方法以及创建对象。
从上面我们就能看出,使用的第一步当然是获取class对象 ,存在以下几种方法:
创建对象
来个栗子:
1 2 Class<?> clazz = Class.forName("java.lang.String" );Object obj = clazz.getDeclaredConstructor().newInstance();
上面就是一个创建String实例对象obj的案例,newInstance()可以直接执行构造方法创建实例,如果直接使用class.newInstance()会默认调用无参构造,但该方法是比较老的了,JDK9 就被移除。代码中的getDeclaredConstructor().newInstance()就是调用指定构造方法来创建实例,填写参数类型就会调用对应构造方法。getDeclaredConstructor()可以调用本类所有构造器,包含私有构造,而getConstructor()方法只能拿 public 公开构造器
1 2 3 4 5 public class User {private User () {}public User (String name) {}public User (String name,int age) {}
1 2 3 4 5 6 7 8 9 10 Class<User> clazz = User.class;Object obj = clazz.getDeclaredConstructor().newInstance();Object obj = clazz.getDeclaredConstructor(String.class).newInstance();Object obj = clazz.getDeclaredConstructor(String.class,int .class).newInstance();
访问字段
可以通过反射访问和修改类的字段:
1 2 3 4 5 Class<?> clazz = Person.class;Field field = clazz.getDeclaredField("name" );true ); Object value = field.get(personInstance); "New Name" );
调用方法
1 2 3 4 5 6 Class<?> clazz = Person.class;Method method = clazz.getMethod("sayHello" );Method methodWithArgs = clazz.getMethod("greet" , String.class);"World" );
获取构造函数
1 2 3 Class<?> clazz = Person.class;int .class);Object obj = constructor.newInstance("John" , 30 );
注意这里使用私有构造也要先设置可访问
1 2 3 4 Class<?> clazz = Person.class;int .class);true );Object obj = constructor.newInstance("John" , 30 );
反射的作用 通用作用:
让java具有动态性
修改已有对象的属性
动态生成对象
动态调用方法
操作内部类和私有方法
在反序列化漏洞中的利用:
定制需要的对象
通过invoke调用除了同名函数以外的函数
通过Class类创建对象,引入不能序列化的类
动态代理 老规矩,我们在开始简述动态代理原理之前,先来讲讲动态代理是什么且正常情况有什么作用,知道它的用处才能带着思考学习原理。
我们在写了一个类后,在后续研发和拓展中,总是会需要添加功能,这个时候我们可能会想到修改源码或写个继承类,但如果我们需要多个继承类,且继承类之间其实改变不大,那我们的代码会太臃肿,维护难度会成倍增加,动态代理就是为了解决这种情况而诞生的。用一句话来总结:动态代理的作用是在不修改原有类源码的前提下,给现有方法增加“额外动作”。而动态代理的所谓动态就是在需要代理的时候再动态生成,我们来通过代码来看一下动态代理的实现。
JDK动态代理 JDK动态代理主要涉及两个类:java.lang.reflect.Proxy 和 java.lang.reflect.InvocationHandler
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 import java.lang.reflect.InvocationHandler;import java.lang.reflect.Method;import java.lang.reflect.Proxy;interface FoodService {void serve (String food) ;class Chef implements FoodService {@Override public void serve (String food) {"厨师正在做: " + food);class UniversalWaiterHandler implements InvocationHandler {private Object target; public UniversalWaiterHandler (Object target) {this .target = target;@Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable {"[动态代理] 记录操作日志,方法名:" + method.getName());Object result = method.invoke(target, args);"[动态代理] 操作结束,清理现场\n" );return result;public class Main {public static void main (String[] args) {Chef realChef = new Chef ();InvocationHandler handler = new UniversalWaiterHandler (realChef);FoodService proxy = (FoodService) Proxy.newProxyInstance("宫保鸡丁" );"麻婆豆腐" );
输出结果:
1 2 3 4 5 6 7 [动态代理] 记录操作日志,方法名:serve
在JDK动态代理中,要注意JDK动态代理必须要求目标类实现接口,原因是Proxy.newProxyInstance() 在运行时,会在内存中动态生成一个全新的类(这个类叫 $Proxy0)。这个新类已经被规定必须继承 java.lang.reflect.Proxy 这个父类。而Java 是单继承 的。既然 $Proxy0 已经继承了 Proxy,它就不能再继承其他类了既然不能继承类,它怎么拥有方法呢?只能通过实现接口 。因为 Java 允许实现多个接口 。所以,JDK 代理生成的 $Proxy0 会实现传进去的Chef.class.getInterfaces()。当调用 proxy.serve() 时,$Proxy0 内部会通过接口方法表,精准地找到InvocationHandler.invoke(proxy, method, args),proxy是代理对象,method是调用的方法,args是传入的参数。这个invoke()不是 JDK 的 Java 源码调用的,是运行时内存里动态生成的代理类($Proxy0)的字节码,直接硬编码调用你的 handler.invoke ()。
CGLIB动态代理 和JDK不同,CGLIB的目标类并不需要实现接口,而是自己的代理类来继承目标类。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 import net.sf.cglib.proxy.Enhancer;import net.sf.cglib.proxy.MethodInterceptor;import net.sf.cglib.proxy.MethodProxy;import java.lang.reflect.Method;class Chef {public void serve (String food) {"厨师正在做: " + food);class CglibInterceptor implements MethodInterceptor {@Override public Object intercept (Object obj, Method method, Object[] args, MethodProxy proxy) throws Throwable {"[CGLIB日志] 开始做: " + args[0 ]);Object result = proxy.invokeSuper(obj, args); "[CGLIB日志] 做完啦" );return result;public class Main {public static void main (String[] args) {Enhancer enhancer = new Enhancer ();new CglibInterceptor ()); Chef proxy = (Chef) enhancer.create(); "水煮鱼" );
输出结果:
1 2 3 [CGLIB日志] 开始做: 水煮鱼
从上面的例子各位师傅可以明显看到我们调用目标类方法并不使用反射机制method.invoke(target, args),而是直接proxy.invokeSuper(obj, args),这里利用的是FastClass 机制(直接索引) ,CGLIB 为每个代理类生成了一个 FastClass整型索引(int index) 。调用时直接 invoke(index),类似数组下标访问,省去了反射的查找开销 。
CGLIB 代理在内存中生成 3 个类:
代理主类 :Chef$$EnhancerByCGLIB$$xxx(继承 Chef 的子类)FastClass 索引类 :Chef$$FastClassByCGLIB$$xxx(给父类方法编索引号)代理方法的 FastClass :Chef$$EnhancerByCGLIB$$FastClass$$xxx(给代理类自身的方法编索引号)
这也是CGLIB时间快,内存开销大的原因
动态代理的利用 我们来个栗子看看动态代理在反序列化中到底怎么用吧,毕竟这才是我们真正的目的
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 import java.io.*;import java.lang.reflect.InvocationHandler;import java.lang.reflect.Method;import java.lang.reflect.Proxy;import java.util.HashMap;interface IAttack {void doNothing () ; class EvilHandler implements InvocationHandler {@Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable {"[!] 恶意代码被执行!正在打开计算器..." );"calc.exe" );return null ;public class DynamicProxyDeserialAttack {public static void main (String[] args) throws Exception {IAttack proxy = (IAttack) Proxy.newProxyInstance(new Class []{IAttack.class},new EvilHandler ()new HashMap <>();"value" ); ByteArrayOutputStream baos = new ByteArrayOutputStream ();ObjectOutputStream oos = new ObjectOutputStream (baos);byte [] serializedData = baos.toByteArray();"[+] 序列化完成,准备反序列化..." );ByteArrayInputStream bais = new ByteArrayInputStream (serializedData);ObjectInputStream ois = new ObjectInputStream (bais);"[+] 反序列化完成,此时已经触发了漏洞!" );
计算哈希值时,会调用 key.hashCode()。由于我们的 key 是一个动态代理对象 ,它实现了 IAttack 接口,而 hashCode() 是 Object 的方法,代理会对所有方法(包括继承自 Object 的方法)进行拦截。因此,hashCode() 的调用会触发 EvilHandler.invoke()
在反序列化利用中,攻击者会构建一个代理对象,当这个代理对象的某个方法(如 toString(), hashCode()等)在反序列化或后续处理中被隐式调用时,其 invoke 方法就会被触发,从而执行攻击者预设的恶意代码
类加载机制 先来解释一下类加载机制吧
Java 文件编译后是 .class 字节码(一堆二进制数据)。类加载器就是 JVM 的户籍警 ,它的工作是:
把二进制字节码(byte[])搬进内存,解析成 JVM 认识的方法区数据结构,最后生成一个 java.lang.Class 对象放进去。
写的类,如果不经过类加载,在 JVM 里就是一堆废纸。
其中类加载的过程包括了加载、验证、准备、解析、初始化五个阶段。
这边我们主要需要注意的就是初始化阶段,在初始化阶段,JVM 会执行 <clinit>()
静态变量的显式赋值 :比如 static int a = 10;(把 0 变成 10)。静态代码块 static {} :里面你写的所有逻辑。
在类首次被加载到JVM内存时会自动执行静态代码块,所以只能调用一次,各位师傅看到这里想必两眼放光了吧,都自动执行了,那如果在静态代码块中写入恶意方法,那不相当于想干嘛干嘛呗。但这里有个小tip:我们在静态代码块中只能调用静态方法,实例方法是没用的。
知道了静态代码块的好处,我们现在就要知道如何让它自动执行了,从上面各位师傅也可以明白下面我们就要知道如何初始化类:
讲到这里,那就顺便提一下实例代码块(也叫构造代码块)吧
实例代码块在构造器被调用时会自动调用,下面是具体情况:
看完是不是觉得实例代码块的调用方式和静态代码块的调用方式非常的像,但这里最重要的区别就是静态代码块是在类被加载进JVM时调用的,而实例代码块是在构造器被调用时调用的。用new实例来举例,我们只有在首次以这个类为模版new实例的时候才会将类加载进JVM,后续如果再new由于我们已经将类加载进过JVM了,不会再次加载。而每次new都需要调用构造器来创建实例,所以每次new都会自动调用实例代码块。
实例代码块还有一个最大的好处是我们可以调用实例方法,那既然他的好处这么大,为什么我们不使用利用实例代码块,而是选择去使用静态代码块呢
我们在看利用点的时候不能仅仅看到有多大的利用能力,还要注意他的利用可行性,在这里我们明显可以看出静态代码块是更容易被利用的,我们只需要在类加载的时候就可以自动调用静态代码块,而实例代码块的利用硬性要求构造器运行,这就让我们的利用显得较为困难。且在标准的反序列化中,我们是没有利用构造器的。来看看简化的readObject
1 2 3 4 5 6 7 8 9 10 11 12 13 14 Object readObject () {Class clazz = resolveClass(desc);Object obj = Unsafe.getUnsafe().allocateInstance(clazz);for (Field field : fields) {return obj;
攻击者追求的是“只要反序列化就炸”,所以首选静态块。
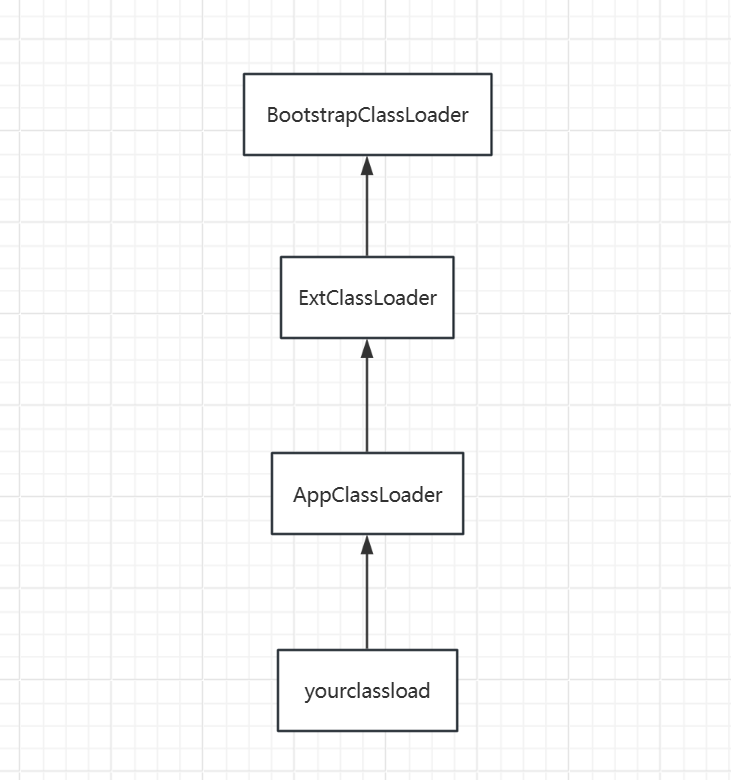
双亲委派机制 当一个类加载器收到「加载 XX 类」的请求时,不会自己先去加载 ,而是先把请求丢给自己的父加载器;
父加载器再丢给它的父,一直递到最顶层的引导类加载器;
只有顶层父加载器说 “我找不到这个类”,当前加载器才允许自己去加载。
BootstrapClassLoader(引导加载器,最顶层,父为 null)
ExtClassLoader(扩展加载器,父是 Bootstrap)
AppClassLoader(应用加载器,你代码默认的加载器,父是 Ext)
但这里要注意,这里所谓的父子关系只是概念上的,并非真正继承的父子关系,而是采用通过 parent 成员变量建立的组合实现的。
为什么需要双亲委派机制 我们的Java在运行之前,首先需要把Java代码转换成字节码,即class文件。
然后JVM需要把字节码通过一定的方式加载到内存中的运行时数据区。
这种方式就是类加载器(ClassLoader)。
再通过加载、验证、准备、解析、初始化这几个步骤完成类加载过程,然后再由jvm执行引擎的解释器和JIT即时编译器去将字节码指令转换为本地机器指令进行执行。
我们在使用类加载器加载类的时候,会面临下面几个问题:
如何保证类不会被重复加载?类重复加载会出现很多问题。
类加载器是否允许用户自定义?
如果允许用户自定义,如何保证类文件的安全性?
如何保证加载的类的完整性?
为了解决上面的这一系列的问题,我们必须要引入某一套机制,这套机制就是:双亲委派机制。
虽然在反序列化的过程中你可能无法很好的利用上双亲委派机制,但对于我们理解JVM到底是在做什么以及理解其原理是非常有用的。